


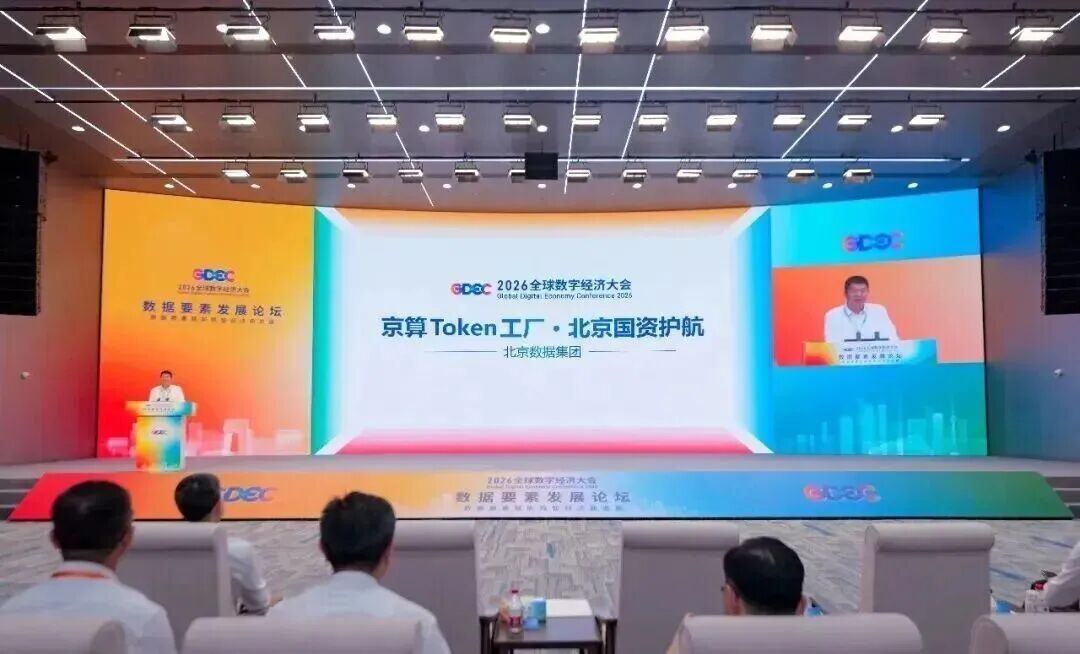
“Token(词元)”是近几年科技圈最火的词语之一,如果说算力被称为AI时代的“数字油矿”,那么Token(词元)则可以被形象比喻为“数字原油”。在北京,这种“原油”正在一家特殊的“工厂”里规模化生产。2026全球数字经济大会数据要素发展论坛上,北京数据集团发布北京首家国资词元工厂——京算Token工厂,标志着首都智能算力服务迈入标准化、普惠化新阶段。
Token(词元)简单来说,就是大模型处理文本的最小单元,举例来讲,当你和当下热门的AI助手聊天时,你说的每一句话,或者下达的每一句指令背后,都在消耗着词元。
在很多人的印象里,算力似乎是个遥远的概念,只存在于科技巨头的机房里,服务于那些高大上的大模型训练。北京数据集团旗下智能院集团副总经理朱璐璐告诉记者,在他看来,Token工厂的出现,意味着算力正在从机房真正走向人们的生活:“过去,海量的算力主要是用来‘炼’模型的,但现在不一样了,经过训练的大模型投入市场,需求规模印证了这一趋势。”2024年初我国日均词元调用量仅为千亿级,到2026年5月已突破170万亿,两年增长超千倍。与此同时,推理算力已占总算力需求近70%,行业发展逻辑正从“拼算力规模”转向“拼Token效率”,大模型付费模式也从一次性训练开支转向持续性推理按需消耗。正是在这一背景下,北京数据集团依托成熟的算力运营积淀,正式入局Token专业化服务赛道。
“传统算力租赁是卖硬件的模式,客户需要自行搭建运维团队、承担底层硬件风险。而京算Token工厂交付的是标准化Token与API成品能力,按实际消耗量按量付费,平台承担底层硬件和集群运维风险,客户无需自建运维团队即可零门槛接入。”朱璐璐解释,就像大家日常生活中的水、电、气、热一样,需要多少就可以买多少。
这种按量计费的模式,让商业逻辑变得异常清晰。无论是包月服务,还是按流量收费,背后的基础都是Token的消耗。但是高速增长的背后,行业发展瓶颈也日益凸显,高端训练与高密度推理算力供给不足、算力综合成本持续攀升、算力资源利用率偏低且供需错配、高密度集群故障风险影响业务稳定性、数据合规安全门槛持续抬升。对于企业和老百姓来说,技术再先进,最终落脚点还是——成本和体验。而作为北京市首家国资词元工厂,京算Token工厂具备七大核心能力。朱璐璐介绍,PD分离智能调度架构,能够精准解决长文本推理低效难题;全栈推理加速框架,大幅提升单卡Token产出效率;异构算力统一调度,打破硬件生态壁垒;全面适配国产大模型生态,实现主流模型全覆盖;精准支撑政务、科创等多元落地场景;弹性计费按需取用,助力企业降本增效;标准化统一接口,零门槛接入,大幅缩短业务落地周期。
依托全栈核心技术,京算Token工厂实现效率、成本、安全的全方位突破。在效率层面,通过异构算力池化调度,将资源利用率从行业普遍的30%至40%提升至80%以上,大幅降低了算力闲置浪费;采用PD分离智能调度架构,算力吞吐量最高提升90%,大模型场景推理时延缩短70%以上。在成本层面,全栈推理加速与PD分离技术协同发力,使长文本场景下单Token成本下降50%以上,客户综合用算成本较传统卡时租赁显著降低。在安全层面,通过定制化服务与解决方案,可实现数据不出域,满足等级保护三级合规要求,从根本上打消企业对数据安全和合规风险的顾虑。
“技术的提升,成本的降低,最终会传导到终端。”朱璐璐说,“AI行业创业者资金投入更低,老百姓使用AI服务的价格也会更亲民。这就是技术进步的普惠意义。”
目前,京算Token工厂已与基流科技、无问芯穹、硅基流动、是石科技等头部AI基础设施厂商达成深度技术合作,整合全域异构算力资源,并携手中关村科服等生态伙伴构建全方位服务能力体系。未来将持续深化与三大运营商的战略合作,打造具备跨模型、跨模态、跨算力平台统一接入能力的“超级入口”,实现“一次接入,全域调用”。
作为北京首家国资词元工厂,京算Token工厂是北京数据集团紧扣北京建设国际科技创新中心定位,主动扛起市属国资担当的体现。未来,这座AI时代的“数字原油”工厂也将持续迭代技术、扩容资源、完善生态,联动京津冀算力资源构建一体化算力集群,助力北京人工智能产业持续领跑全球。

 京公网安备 11010202008069号